同じプロンプトで3モデル比較:Banana / Image 2 / 2.5
どれが勝つかではなく、構図・テキスト・ディテール・追従性のどこで崩れるかに注目。モデル選定には「一言で決まるチャンピオン」より役立つ。
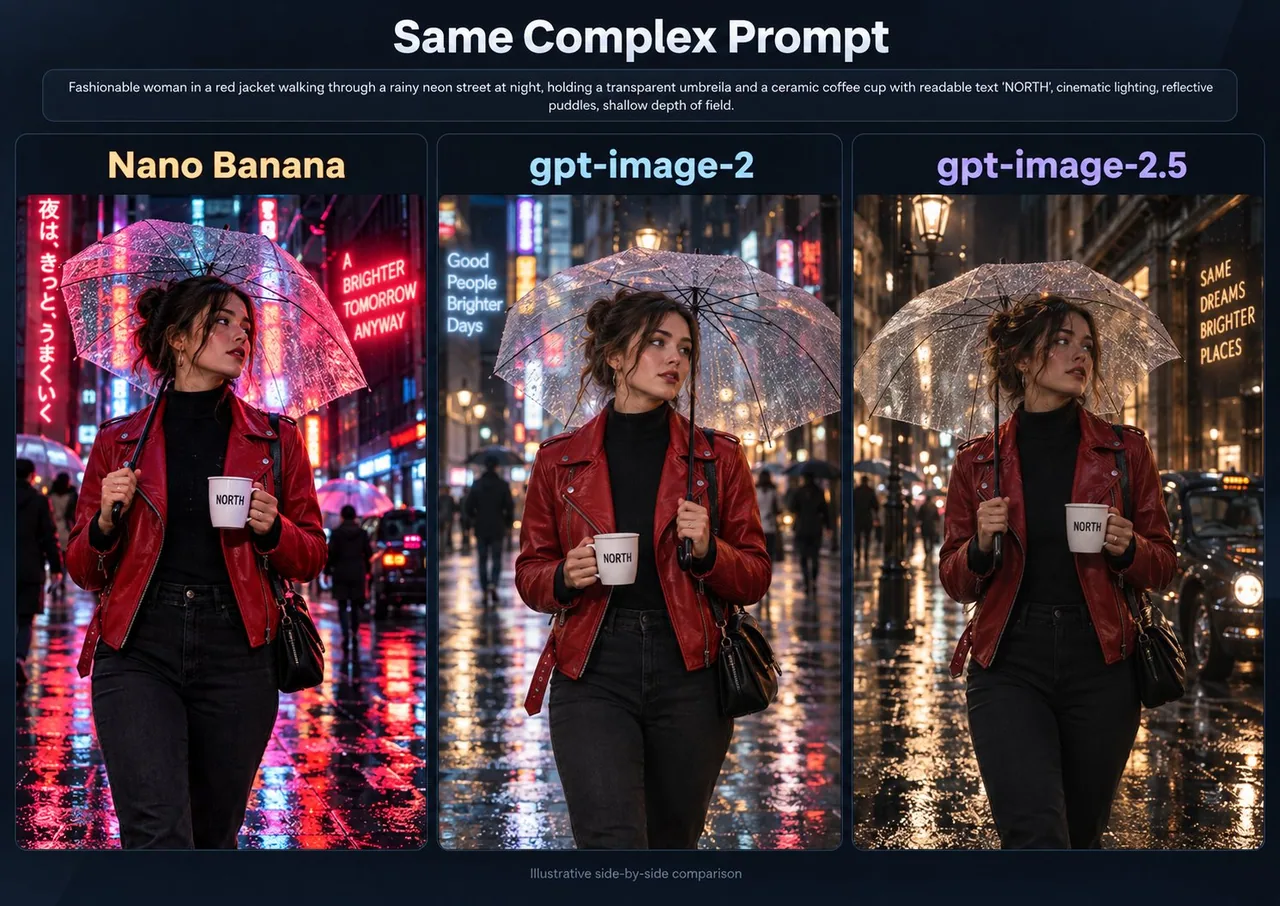
プロンプト
Same prompt. Three image models.

Nano Banana vs GPT Image 2 vs GPT Image 2.5.

I care less about which model “wins” and more about where each one breaks:
composition, text, detail, and prompt adherence.
One default image model rarely wins every job.
日本語訳
同じプロンプト。3つの画像モデル。

Nano Banana vs GPT Image 2 vs GPT Image 2.5。

どのモデルが「勝つか」よりも、それぞれがどこで崩れるかのほうが気になります:
構図、テキスト、ディテール、プロンプトへの追従性。
1つのデフォルト画像モデルがすべての仕事で勝つことはほとんどありません。
出典
- 原作者
- apimartlabs
- 公開日
- 2026-09-10
- 原典
- 元の投稿を見る ↗
- 収録元
- xianyu110/awesome-gpt-image2.5 · 2097958537284751416 · MIT